← 목록으로
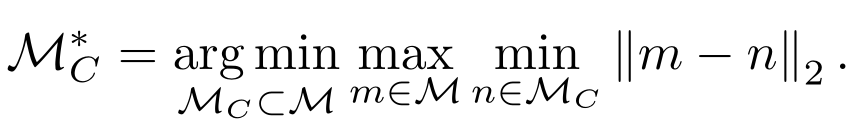
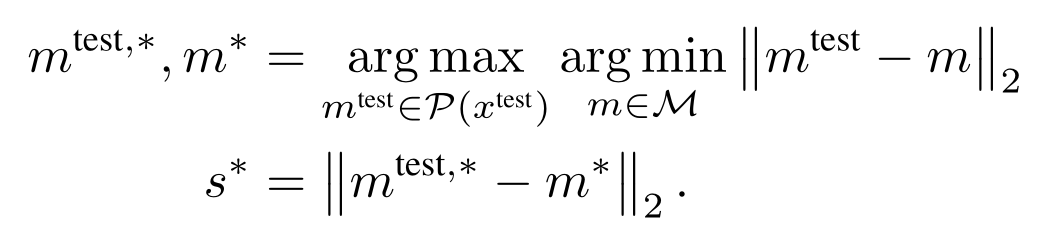
PatchCore
Anomaly Detection
Anomaly Detection(AD)은 여러 분야에서 다양하게 사용됩니다. 보안에서는 외부 침입 감지에 사용될 수 있고 의료에서는 정상과 환자를 구분하는데 사용될 수 있습니다. 오늘 소개할 논문은 제조 분야에서 사용되는 이미지 기반의 AD기법에서 가장 대표 모델인 PatchCore를 소개하겠습니다. 해당 논문은 2022년에 출판되었으며 오랜시간 이미지 기반의 AD 연구에서 비교모델로 사용되고 있으며 대표적인 모델이라고 볼 수 있습니다.산업 분야에서 2D 이미지 기반의 AD는 제품 외관에있는 결함을 탐지하는데 주로 사용됩니다. 일반적으로 computer vision에서는 classification과 segmentation 모델로 제품의 양/불량을 판단하고 결함 부위를 감지할 수 있지만 두 모델은 지도학습(supervised learning) 방식이기 때문에 라벨링이 반드시 필요합니다. Deep Learning 기반의 지도학습 모델은 학습 데이터가 적어도 1000개 이상이 있어야지 믿을 만한 성능의 모델을 구축할 수 있습니다. 하지만 실제 산업에서는 불량 제품이 많이 생산되지 않기 때문에 데이터를 다량으로 수집하는데 오랜시간이 소요됩니다. 반면에 양품 데이터는 쉽게 얻을 수 있으며 이처럼 불량을 감지하고 싶으나 불량 데이터가 희소한 경우에 AD 기법이 사용 될 수 있습니다.
PatchCore
PatchCore는 대표적인 AD 모델 중에 하나로, 메모리 뱅크 기반으로 이상탐지를 수행합니다. 메모리 뱅크 방식은 embedding-based methods에 속하며, 이외에도 reconstruction-based methods와 synthesis-based methods가 있습니다. PatchCore는 PaDiM을 보완한 모델이며 PaDiM보다 계산 속도가 빠르고 개별 패치를 사용하는 PaDiM과 달리 주변 패치 정보까지 활용하여 이상 탐지 능력을 더 향상시킨 모델입니다. PaDiM에 대한 설명은 지금은 생략하겠습니다.
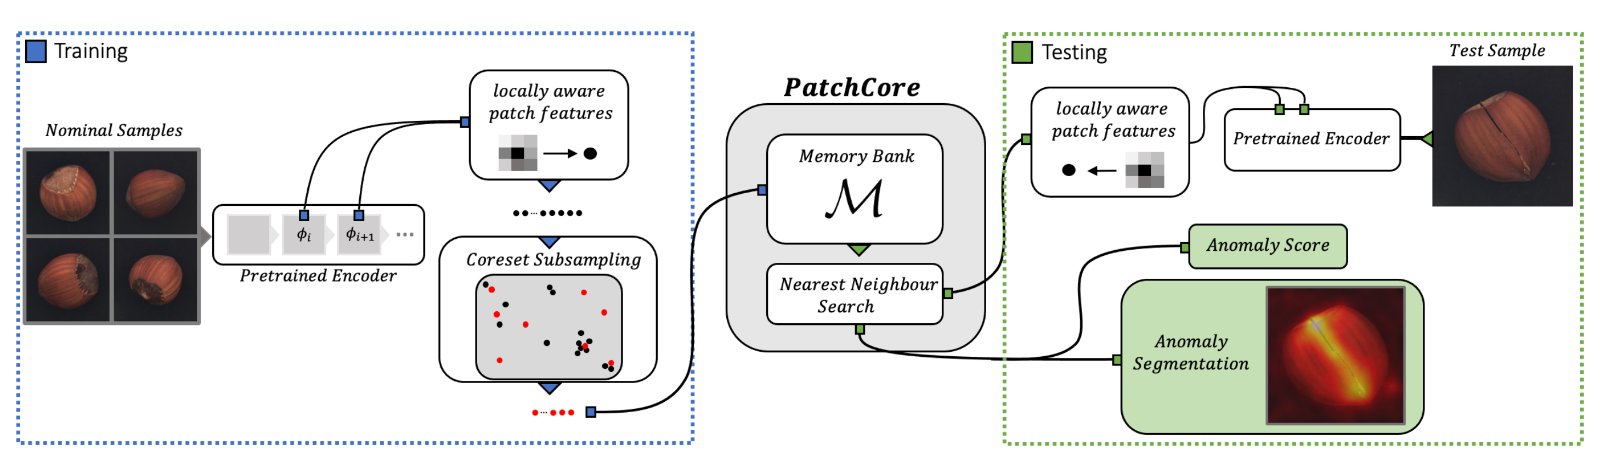
PatchCore의 전체 프로세스는 아래 그림과 같습니다.
...
[Training]
1. 정상 샘플 이미지 데이터를(Normal samples) Wide-ResNet과 같은 CNN기반 모델에 대입하여 특징을 추출합니다.
- 특징을 추출하는데 사용되는 layer는 모델의 마지막 부분이 아니라 모델의 중반 정도의 layer를 사용합니다.
- 모델의 후반부에 있는 layer에서 특징을 추출하면 모델이 기존에 학습된 데이터셋에 영향을 많이 받게되어 우리가 특징을 추출하고자 하는 이미지의 특성이 아니라 기존 학습 데이터셋의 특징이 같이 반영될 수 있기 때문입니다.
- 반면에 초반부에 있는 layer를 사용하는 경우, 모델 학습이 미숙하여 이미지에 있는 특징을 제대로 추출할 수 없습니다.
2. 추출된 특징 패치를 이웃 패치와 결합(aggregation)하여 하나의 patch로 사용합니다.
- 논문에서는 Adaptive_average_pool2d을 사용하여 주변 패치의 정보를 결합합니다.
- 1개 layer에서 추출된 feature 만을 aggregation하는 방식과 2개 layer에서 추출된 feature를 aggregation하는 Multi-Hierarchy 방식이 있습니다.
- Multi-Hierarchy Aggregation 은 두 layer에서 추출된 feature를 각각 aggregation하여 feature shape를 맞춰준 뒤에 concat를 수행하고 다시 aggregation하여 target dim 형태로 만들어줍니다.
- 해당 연구에서는 단일 layer보다 Multi-layer를 사용한 경우가 성능이 더 좋다고합니다.
- 중간 레벨의 layer와 후반 레벨의 layer를 혼합한 경우에 좀 더 풍부한 feature 정보를 얻을 수 있기 때문입니다.
3. Coreset Subsampling
- 2번에서 결합한(aggregation) 특징 패치 중에서 중요한 패치만 선별합니다.
- 선별하기 전에 고차원인 특징 패치를 저차원으로 사영(Projection)하여 계산량을 줄입니다.
- 저차원 사영 방법으로 Johson-Lindenstrauss인 random projection을 사용합니다.
- Johson-Lindenstrauss 정의에 따르면 고차원 공간의 점들을 저차원으로 사영했을 때, 거리를 거의 보존할 수 있습니다.
- 저차원으로 사영을 수행한 뒤에 아래 조건을 만족하는 Mc를 찾는다.
- 최종 Mc를 메모리 뱅크로 저장한다.
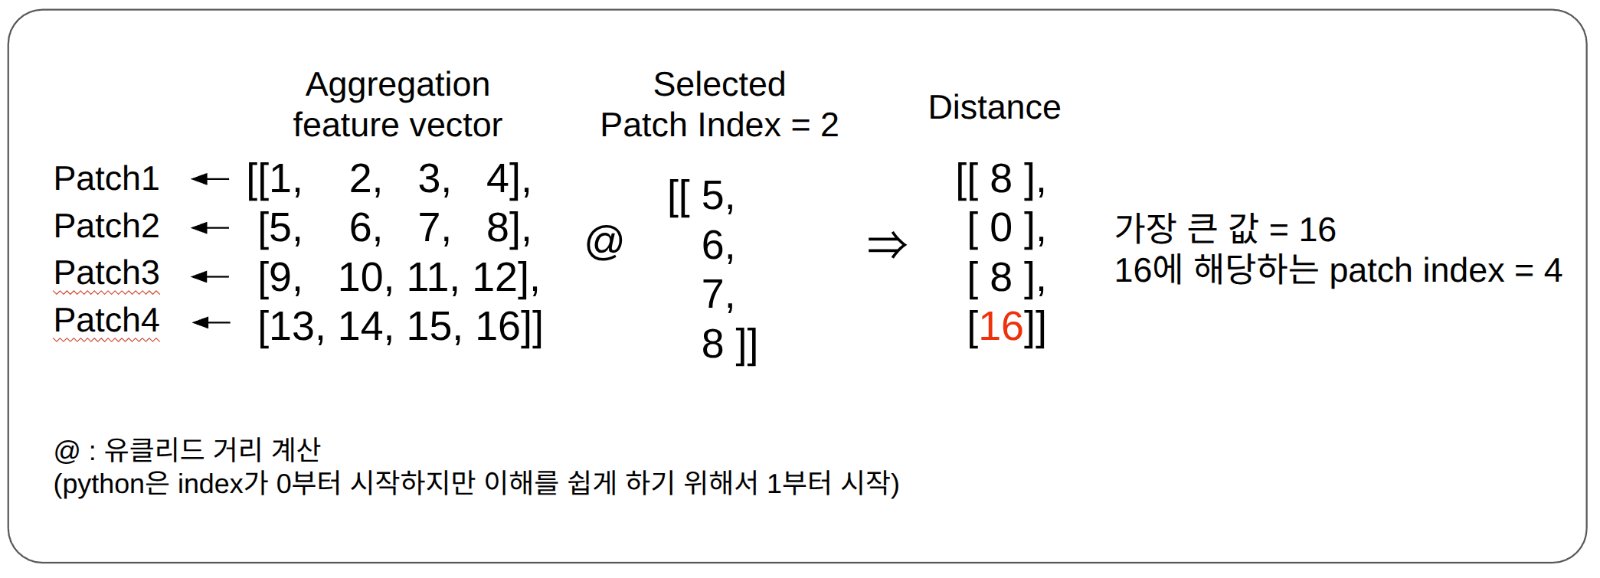
- 예시 : Training에서 3번에 저차원으로 feature를 projection한 이후에 Mc를 찾는 과정
1. 첫번째 iteration
- 첫번째 index 2는 random으로 선택함, 다음 iteration에서는 distance가 16(빨간색)으로 가장 큰 4번째 patch를 비교
- 유클리드 거리는 유사성을 나타냄. 거리가 가까울수록 유사성이 높고 거리가 멀수록 유사성이 낮음
- 거리값이 가장 큰 16은 2번째 patch와 4번째 patch가 많이 다른 형태의 데이터라는 것을 의미
→ 독특한 데이터일 가능성이 높음
→ 특징이 두드러짐
→ 수많은 patch에서 중심이 되는 core patch일 가능성이 높음
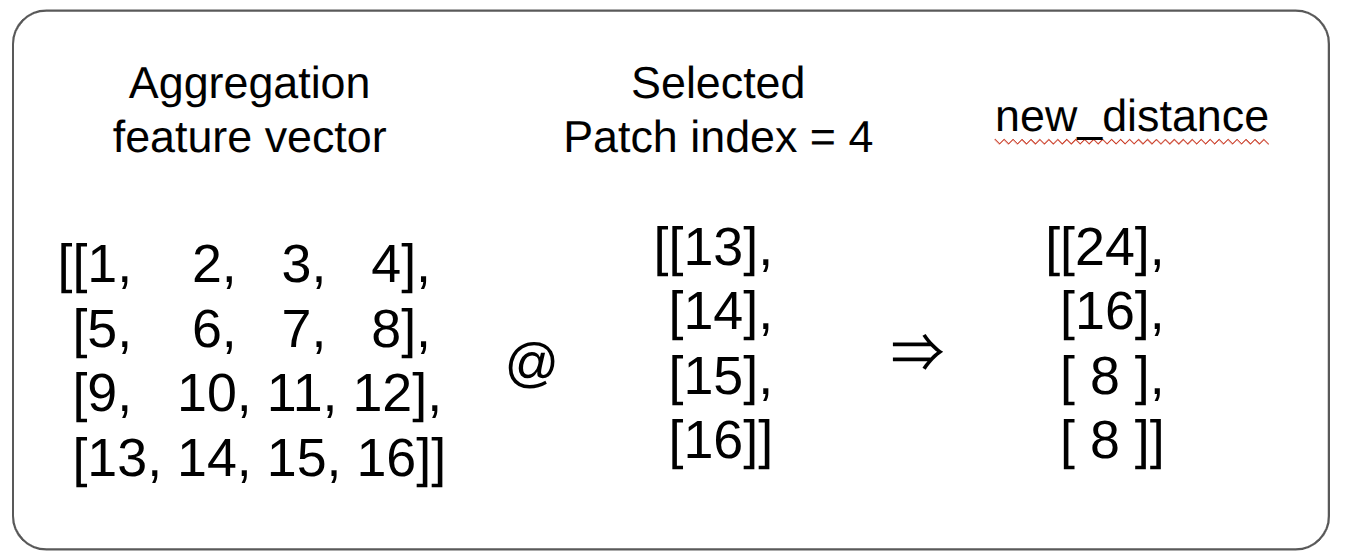
2. 두번째 iteration
- 4번째 patch와 다른 patch와의 유클리드 거리 계산
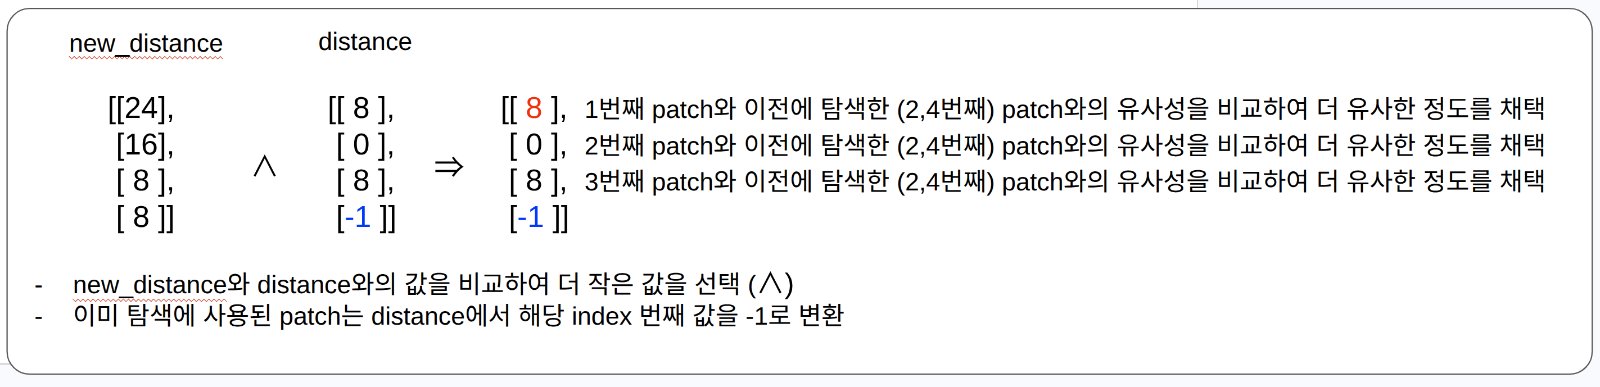
- 거리의 최소값을 선택하고 그중에서 가장 큰 거리 값(빨간색)을 가지는 1번째 patch를 선택
- 최소값을 선택했다는 것은 가장 유사한 patch를 선택했다는 의미이며 그중에서 최솟값 중에서 가장 큰 값을 선택했다는 것은 가장 유사한 값을 선택했음에도 불구하고 여전히 다른 patch들과 많이 다르다는 의미
- 유클리드 거리가 가장 큰 patch를 선택 = 가장 특이한 patch를 선택
- 배경과 같은 평범한 데이터가 아니라 제품의 독특한 특징을 메모리 뱅크에 담아야 하므로 특이한 patch를 메모리 뱅크에 저장해야 나중에 이상치 데이터와 비교했을 때 차이를 쉽게 구별 가능.
3. 최종 메모리 뱅크
- Selected index에 해당하는 patch들만 메모리 뱅크에 저장함=> selected_index = Coreset Subsample index = [2,4,1]
[Testing]
1. 테스트 이미지를 Training의 1~2번 과정을 똑같이 진행합니다.
2. 테스트 이미지의 특징과 메모리 뱅크를 이용하여 Anomaly Score(AS)를 계산합니다.
- 패치 중에서 가장 큰 AS를 해당 이미지의 대표 AS로 간주합니다.
- Anomaly Score 계산식
- 테스트 patch와 메모리 뱅크와의 유클리드거리 값을 단순히 anomaly score로 사용하는 것이 아니라 softmax를 기반으로 가중치를 계산하여 최종 anomaly score로 사용
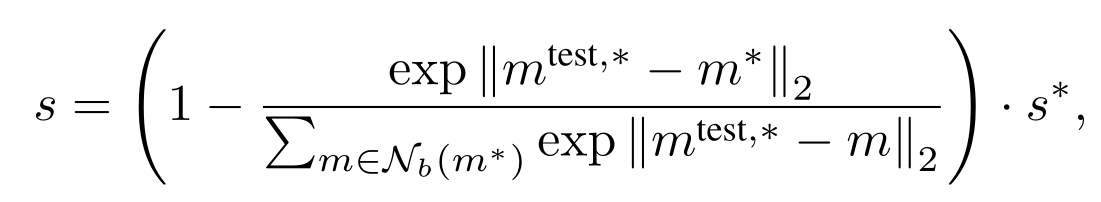
a-1. 전체 테스트 이미지 patch 한개와 메모리 뱅크에 있는 모든 patch 사이의 유클리드 거리 계산 후 가장 작은 값을 채택
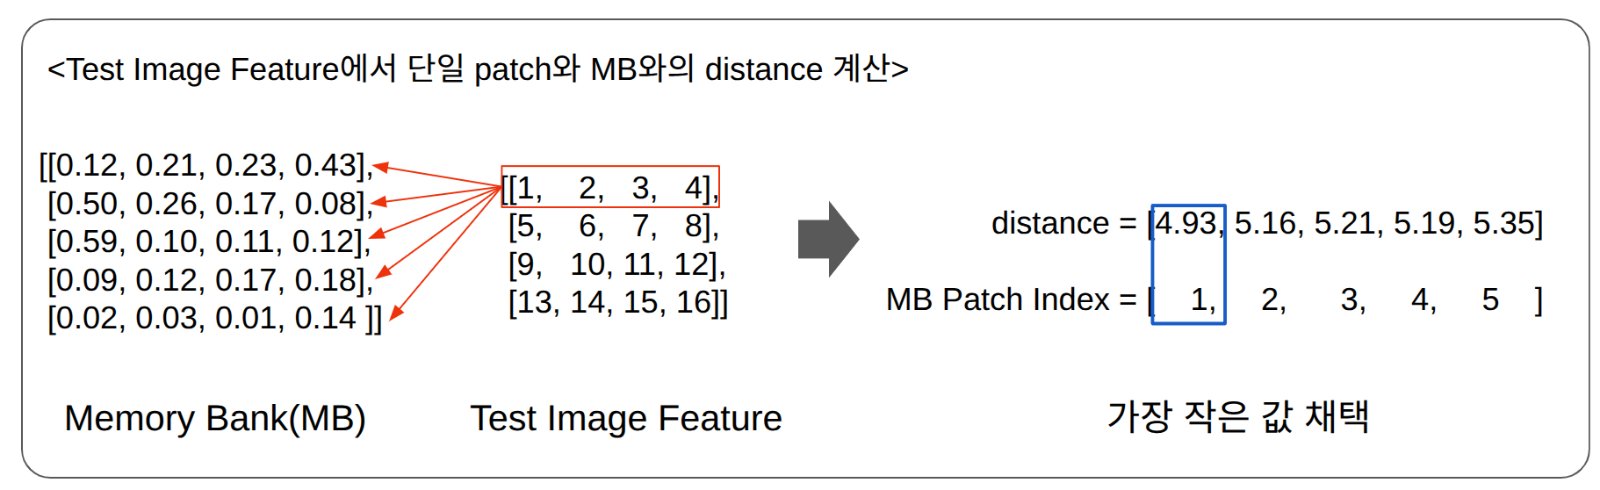
a-2. 모든 테스트 patch에 대해서 최소 거리를 계산 후, 가장 큰 값을 가지는 메모리 뱅크의 patch를 찾음 = m*
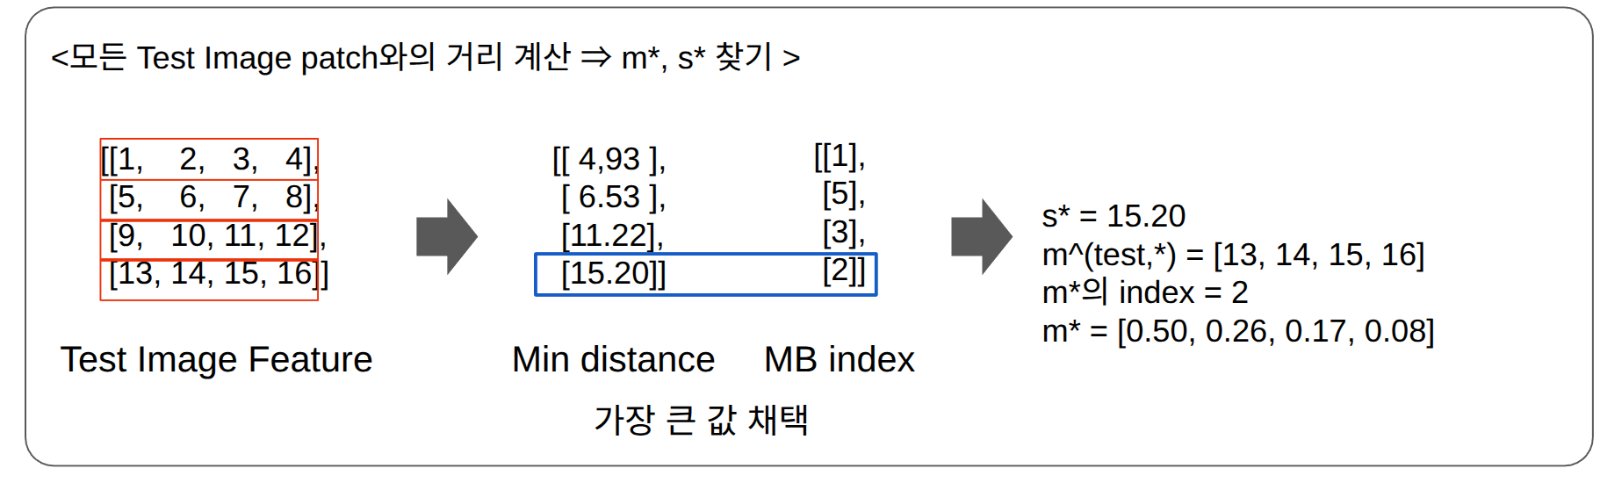
b-1. anomaly score에 사용될 가중치를 계산하기(softmax)
b-2. m*와 메모리 뱅크 사이의 유클리드 거리 계산을 수행 후 거리값이 작은 상위 k를 이웃 patch로 설정 = Nb(m*)
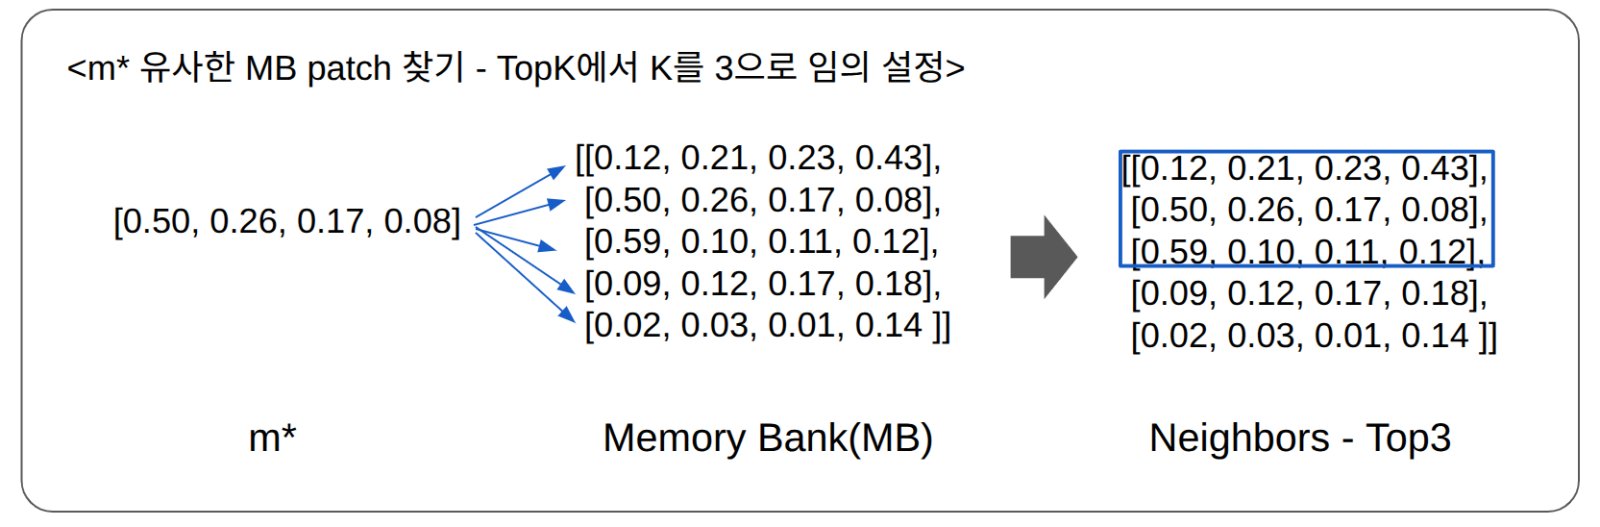
b-3. 가중치 계산
+ 이웃 patch와 테스트 patch 와의 유클리드 거리 계산 후 해당 값의 합에 지수를 취한 값을 가중치의 분모로 사용
+ 분자는 테스트 patch와 메모리 뱅크 사이의 가장 작은 유클리드 거리 값에 지수를 취함
+ 최종 가중치 계싼 : 1-(b-3/b-4)
softmax를 사용하는 이유
- softmax를 사용해서 이웃 patch와 m* 와의 차이를 가중치로 주기 위함
- 가중치가 큼
- m*가 이웃들과 유사한 경우
- test patch가 확실히 메모리 뱅크와 차이가 있다는 의미
- 가중치를 크게 함으로써 anomalous를 확실하게 표현
- 가중치가 작음
- m*가 이웃들과 다른 경우
- test patch가 우연히 메모리 뱅크에 저장되지 않은 영역과 유사해서 발생한 경우 일 수도 있음 coverage 부족
- coverage 부족으로 인한 노이즈인지 실제로 차이가 적은 것인지 확실히 알 수 없으므로 가중치를 낮게 설정 = false positive를 줄임
3. 모든 patch에 대해서 AS가 계산이 완료되면 원본 이미지 크기로 복원합니다.
- interpolation을 사용하여 anomaly score map을 원본 이미지 크기로 복원합니다.
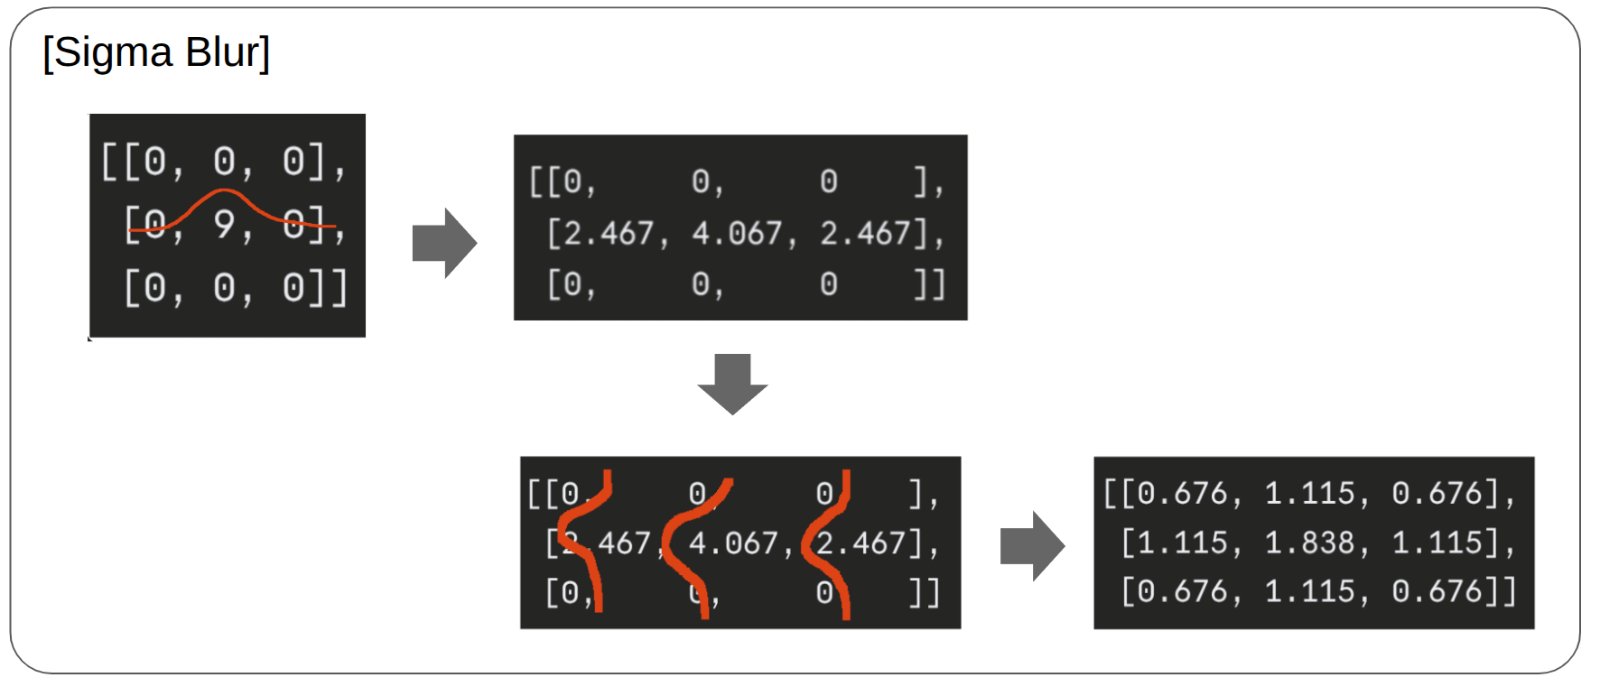
- Sigma blur를 사용하여 smooth하게 합니다.
4. 양품/불량 판단하기
- 양품 데이터들의 AS를 계산하여 양품 AS 분포를 구합니다. 여기서 AS는 patch 중에서 anomaly score가 가장 큰 값입니다.
- 테스트 이미지의 AS 점수가 양품 AS 분포에서 95% 이상에 속하면 이상치로 판단합니다.
5. 히트맵 그리기
- 양품 데이터의 AS 분포에서 하위 5%와 상위 95% 이상을 버리고 나머지 데이터에서 최솟값과 최댓값을 기준치로 설정합니다.
- 3번에서 복원한 이미지 feature map을 이전에 계산한 양품 AS의 최솟값과 최댓값으로 정규화를 수행합니다.
- 정규화를 하는 이유는 절댓값으로 시각화를 진행시, 아주 작은 AS에도 이상치처럼 보이기 때문에 양품의 AS를 기준으로 정규화를 수행하여 양품 범주에서 벗어난 부분만을 확대해서 볼 수 있습니다.
 GitHub
 LinkedIn