지난 시간에는 Active Learning(AL)의 쿼리 시나리오에 대해 알아보았습니다. 문제를 해결하는 데이터 유형과 환경에 따라 쿼리 시나리오가 달라진다는 점을 배웠습니다. 이번 시간에는 좋은 Active Learning 전략을 찾기 위한 기준(criteria)에 대해 살펴보겠습니다.
좋은 Active Learning 전략이란?
Active Learning은 라벨이 없는 데이터 샘플 중에서 모델 학습에 가장 큰 영향을 주는 데이터 샘플을 선택하는 기법입니다. 따라서 좋은 Active Learning 전략이란, 모델 학습에 크게 기여하는 데이터를 효과적으로 선택할 수 있는 전략이라고 볼 수 있습니다.
그렇다면 “모델 학습에 크게 기여한다”는 것은 구체적으로 무엇을 의미할까요?
이는 특정 데이터를 학습함으로써 모델의 성능(정확도)이 크게 향상되는 것을 뜻합니다. 즉, 모델이 학습하지 않았던 데이터를 학습하면 정확도가 크게 개선되는 경우입니다.
예시: 바나나 이미지 분류
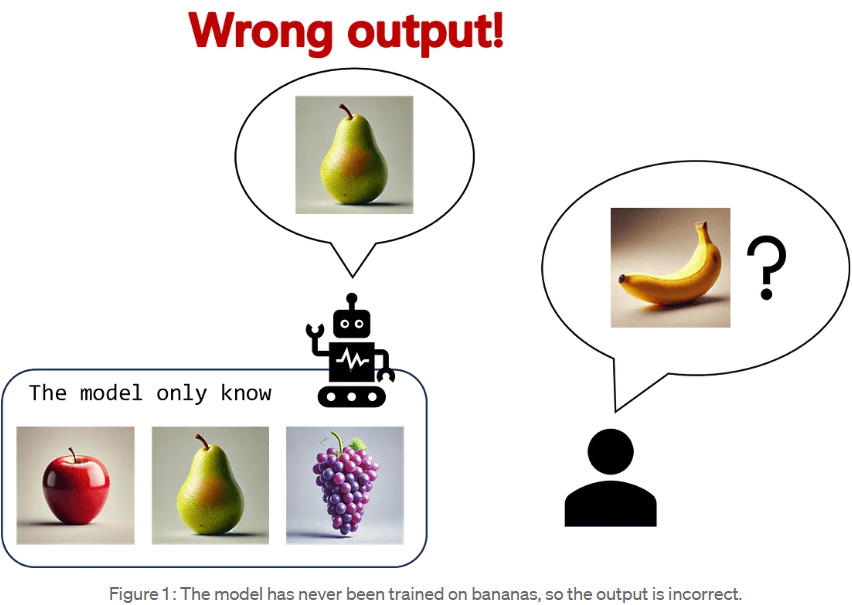
예를 들어, 사과·배·포도를 구분하는 이미지 분류 모델이 있다고 합시다. 여기에 바나나 이미지를 넣으면 어떻게 될까요?
모델은 바나나를 학습해본 적이 없기 때문에 잘못된 결과를 낼 가능성이 큽니다.
하지만 바나나 데이터를 추가해 모델을 다시 학습시킨다면, 그 후에는 바나나를 올바르게 분류할 수 있게 됩니다.
Figure 1 : 모델이 바나나를 학습한 적이 없어 출력이 잘못된 경우.
이처럼 모델이 아직 학습하지 않았고, 오차가 큰 데이터는 모델 학습에 크게 기여하는 데이터라고 할 수 있습니다. 이 데이터를 평가하는 기준이 바로 정보량(Informativeness)이며, 이는 모델의 불확실성(uncertainty)으로 측정됩니다.
불확실성을 측정하는 대표적인 지표가 바로 엔트로피(Entropy)로, 정보이론에서 나온 개념입니다.
정리하면, 불확실성이 높을수록 데이터의 정보량이 크고, 따라서 우선적으로 라벨링해 학습해야 한다는 것입니다.
두 번째 기준: 대표성 (Representativeness)
말 그대로, Active Learning에서 선택된 데이터는 전체 데이터셋의 특성을 잘 대표해야 합니다.
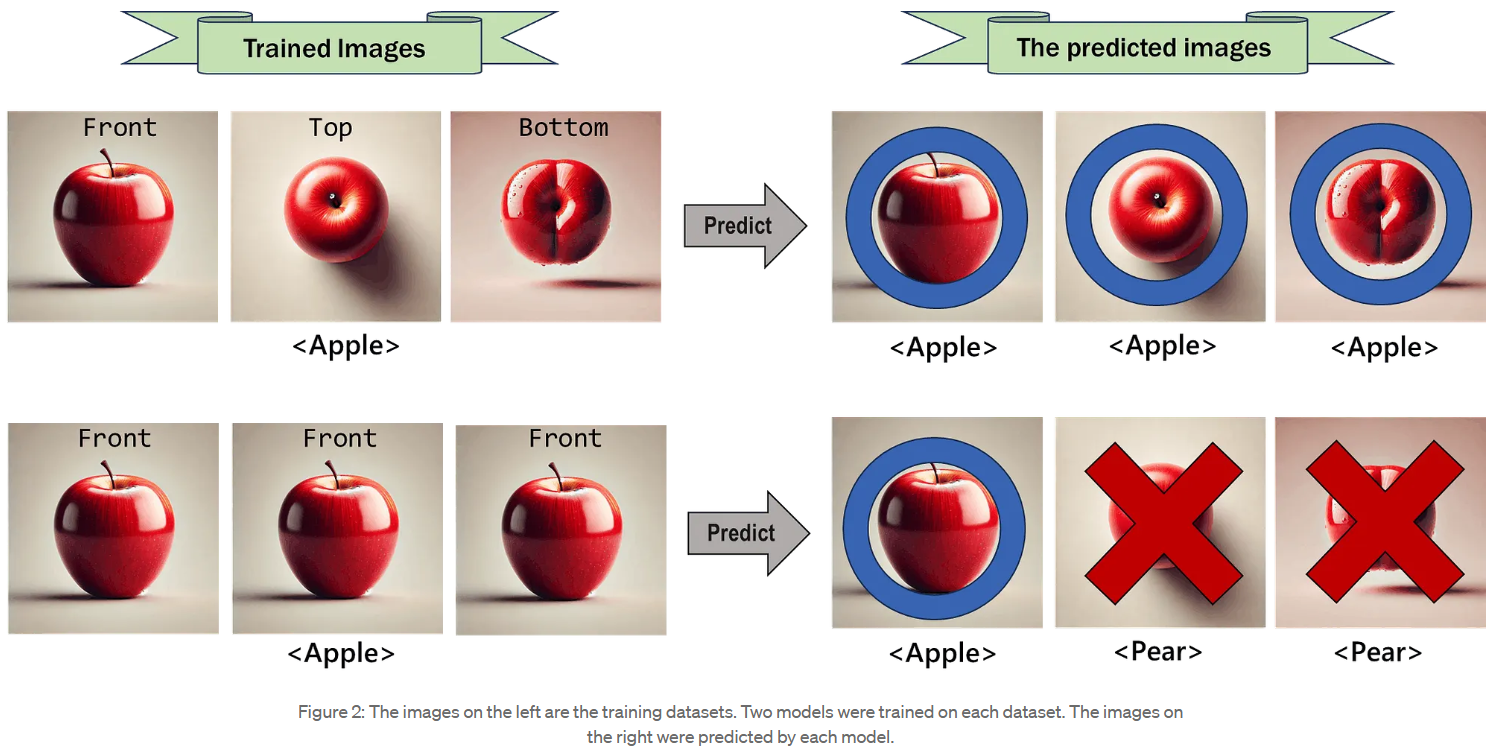
예를 들어, 사과·배·포도의 정면, 아래쪽, 위쪽 사진이 각각 50장 있다고 가정합시다. 만약 정면 사진만 가지고 모델을 학습하면 성능이 좋지 않을 것입니다. 반면, 정면·아래·위 모든 방향에서 학습한 모델은 더 높은 성능을 보일 수 있습니다.
Figure 2 : 왼쪽은 학습 데이터셋, 오른쪽은 각 데이터셋으로 학습된 모델의 예측 결과.
따라서 대표성 있는 데이터를 포함해야 모델의 전반적 성능이 개선됩니다.
세 번째 기준: 다양성 (Diversity)
다양성은 말 그대로 데이터가 한쪽에 치우치지 않고 골고루 포함되어야 함을 의미합니다.
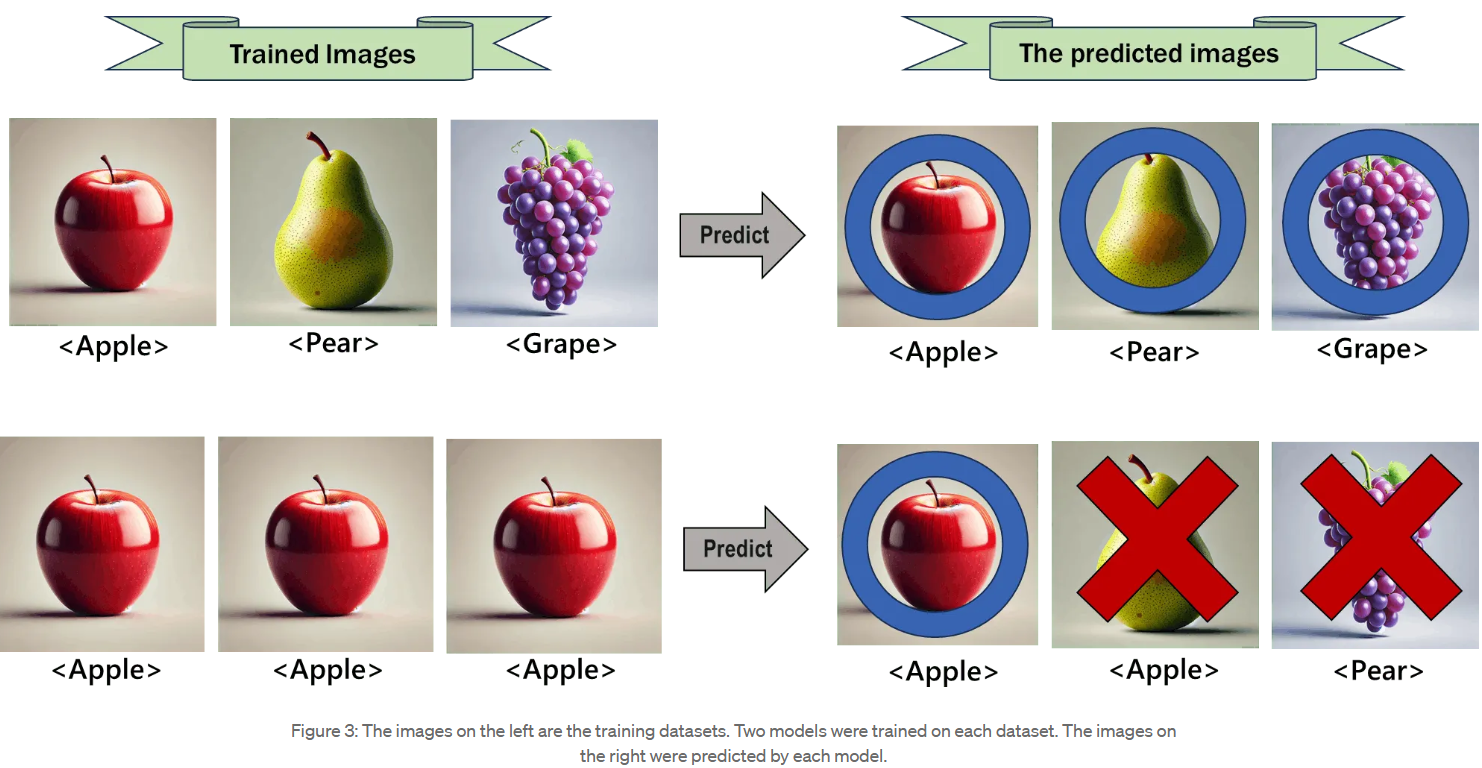
다시 사과·배·포도 예시를 생각해봅시다. 만약 모델이 배 이미지만 학습했다면, 모델은 배는 잘 분류할 수 있겠지만 사과나 포도는 분류하지 못합니다.
Figure 3 : 왼쪽은 학습 데이터셋, 오른쪽은 각 데이터셋으로 학습된 모델의 예측 결과.
즉, 모델이 아직 탐색하지 않은 새로운 영역의 데이터를 학습해야 제대로 된 성능을 발휘할 수 있습니다.
정리
지금까지 Active Learning을 평가할 수 있는 세 가지 기준을 살펴보았습니다.
- 정보량 (Informativeness) – 불확실성이 큰 데이터일수록 우선순위가 높다.
- 대표성 (Representativeness) – 전체 데이터셋의 특성을 잘 대표해야 한다.
- 다양성 (Diversity) – 데이터가 특정 범주에 치우치지 않고 골고루 분포해야 한다.
따라서 좋은 Active Learning 전략이란 정보량, 대표성, 다양성이 높은 데이터셋을 구축할 수 있는 전략이라고 할 수 있습니다.
다음 시간에는 본격적으로 Active Learning 전략을 더 깊이 있게 다뤄보겠습니다.
[References]
[1] Settles, Burr. “Active learning literature survey.” (2009).
[2] D. Wu, “Pool-Based Sequential Active Learning for Regression,” in IEEE Transactions on Neural Networks and Learning Systems, vol. 30, no. 5, pp. 1348–1359, May 2019, doi: 10.1109/TNNLS.2018.2868649.
 GitHub
 LinkedIn