지난번에는 Active Learning(AL)이 무엇인지 간단히 소개하고, 왜 필요한지에 대해 이야기했었습니다. 오늘은 본격적으로 기법에 들어가기 전에 앞서 잠깐 언급했던 쿼리 시나리오(Query Scenario)에 대해 설명드리겠습니다.
쿼리 시나리오란?
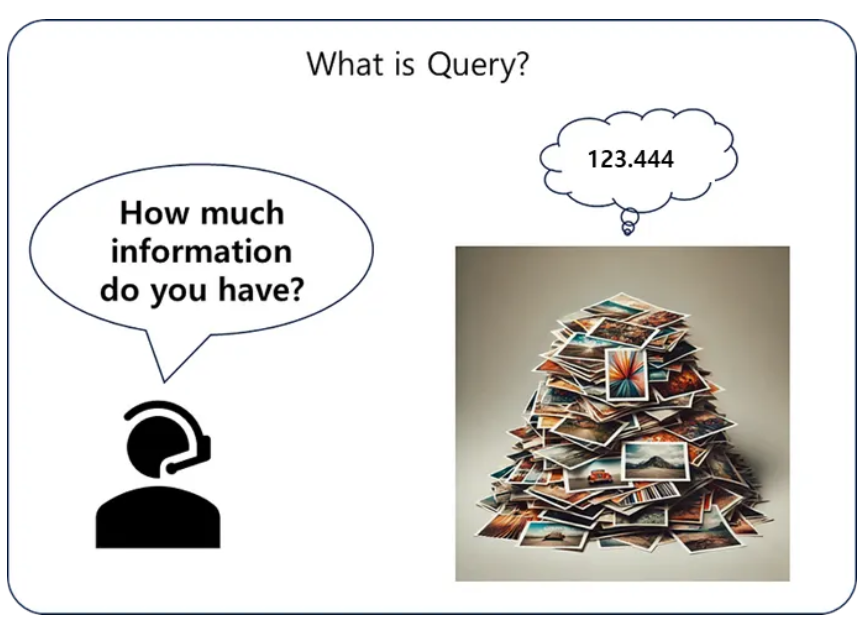
쿼리 시나리오란 라벨이 없는 데이터셋(Unlabeled Dataset)에서 머신러닝 모델 학습에 도움이 될 데이터를 선택하기 위해 데이터를 질의(Query)하는 방법을 말합니다.
AL에서는 데이터를 향해 질문을 던지는 과정이라고 볼 수 있습니다.
예를 들어 Figure 1에서처럼, “너는 얼마나 많은 정보를 가지고 있니?”라고 물었을 때 데이터가 “나는 123.444만큼의 정보를 가지고 있어”라고 응답한다고 합시다. 이 응답을 바탕으로 해당 데이터의 중요성이나 활용도를 판단할 수 있습니다. 이 과정을 통해 어떤 데이터를 우선적으로 라벨링하고 학습에 활용해야 할지 결정할 수 있는 것이죠. 여기서 123.444라는 값은 단순 예시이며, 실제로는 여러 계산 기법을 통해 산출됩니다. 이런 기법들이 바로 Active Learning입니다.
데이터의 형태(이미지, 표, 텍스트 등)에 따라 질의 방법이 달라집니다. 대표적인 쿼리 시나리오는 Pool-based와 Stream-based(또는 Population-based)입니다.
Pool-based 시나리오
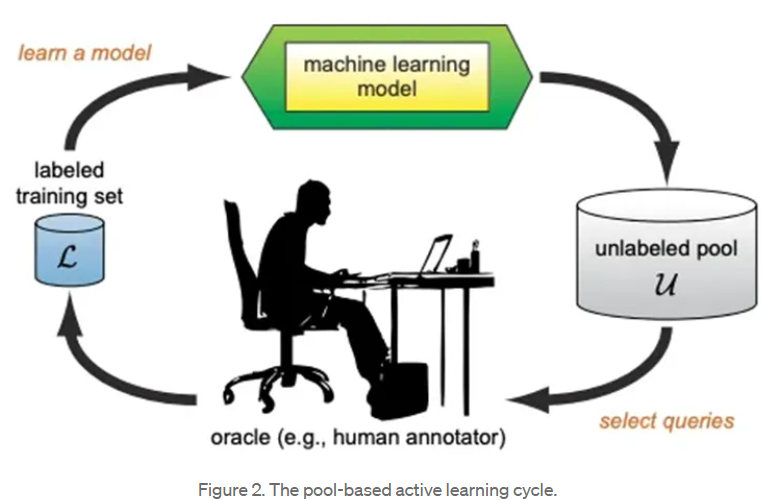
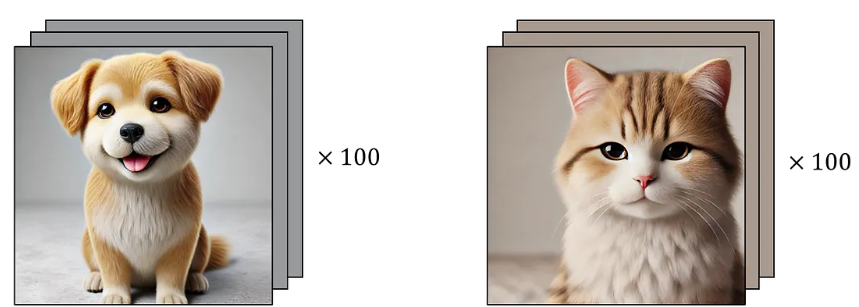
예를 들어, 고양이 사진 100장과 강아지 사진 100장이 들어있는 정적 데이터셋이 있다고 합시다. 이 데이터셋은 변하지 않으며, AL은 이 풀에서 가장 정보량이 많은 데이터를 뽑아 라벨링하고 학습에 사용하는 구조입니다.
Population-based 시나리오
Population-based Scenario는 데이터의 분포(distribution)를 미리 알고 있어 데이터를 생성할 수 있는 경우를 말합니다.
예를 들어 복잡한 다항식 함수(peak function)를 생각해 봅시다 (Figure 2 참조).
입력값 x를 주면 대응되는 출력값 y를 계산할 수 있습니다.
x의 범위는 [-∞, +∞]로 무한하므로, 원하는 입력을 넣어 언제든 y를 얻을 수 있습니다.
이처럼 입력 범위가 무한하고 분포(함수)를 알고 있는 경우 Population-based 시나리오를 적용할 수 있습니다.
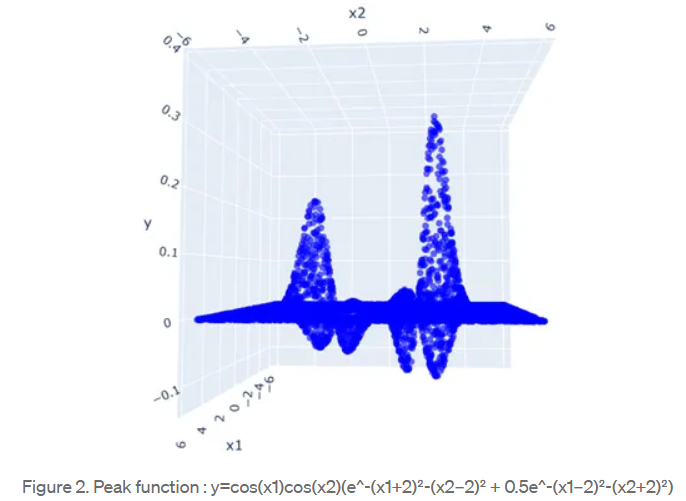
물론 미리 1,000개의 x값을 뽑아 풀(pool)을 만들어 Pool-based 방식을 적용할 수도 있습니다. 하지만 무한한 범위에서 단지 1,000개만 샘플링하면 중요한 데이터 포인트를 놓칠 수 있습니다. 이런 이유로, 함수 기반 데이터에는 Population-based 접근이 일반적으로 권장됩니다.
Stream-based 시나리오
Stream-based(스트림 기반 선택 샘플링 또는 순차적 AL) 방식은, 말 그대로 데이터 스트림 상황에서 사용됩니다.
새로운 데이터가 연속적으로, 실시간으로 들어올 때 사용됩니다.
새로운 데이터가 들어올 때마다 라벨링을 할지, 버릴지를 즉시 결정해야 합니다.
데이터는 한 번에 하나씩 들어오므로 Sequential Active Learning이라고도 합니다.
실제 환경에서 데이터가 끊임없이 발생하는 문제(예: 자율주행차의 도로 영상 수집)에서 유용하게 쓰이는 방식입니다.
회귀(Regression) vs 분류(Classification) 문제에서의 적용
이제 어떤 시나리오가 일반적인 ML 문제(회귀, 분류)에 적용될 수 있을지 살펴봅시다.
- 회귀 문제 (Regression)
Population-based 시나리오가 주로 사용됩니다. (예: Peak function 예시)
하지만 Boston Housing Price Dataset 같은 경우는 Population-based 방식을 사용할 수 없습니다. 왜냐하면 데이터의 분포를 알 수 없고, 독립 변수의 범위도 무한하지 않기 때문입니다. 따라서 이런 표 형태(tabular)의 회귀 문제에는 Pool-based 방식이 적합합니다.
결론적으로 Population-based는 함수 기반 회귀 문제에서 주로 사용됩니다.
- 분류 문제 (Classification)
보통 Pool-based 방식이 사용됩니다.
하지만 자율주행에서 실시간으로 도로 주행 데이터를 수집하고 객체 분류 모델을 구축하는 경우처럼, 실시간 데이터가 들어오는 상황에서는 Stream-based 방식을 적용할 수 있습니다.
대부분의 분류 문제에서는 Pool-based 방식이 일반적입니다.
[References]
[1] Settles, Burr. “Active learning literature survey.” (2009).
[2] D. Wu, “Pool-Based Sequential Active Learning for Regression,” in IEEE Transactions on Neural Networks and Learning Systems, vol. 30, no. 5, pp. 1348–1359, May 2019, doi: 10.1109/TNNLS.2018.2868649.
[3] Jiang, Ping, et al. “A novel sequential exploration-exploitation sampling strategy for global metamodeling.” IFAC-PapersOnLine 48.28 (2015): 532–537.
 GitHub
 LinkedIn