대부분의 사람들이 AI 또는 머신러닝을 떠올릴 때, 아마도 AI 모델을 먼저 생각할 것입니다. 예를 들어, Chat-GPT와 같은 생성 모델, 사람 얼굴이나 특정 객체를 감지하는 YOLO, Mask-RCNN과 같은 객체 탐지 모델, 이상 탐지나 예측을 위한 예측 모델, 혹은 고객을 분류하는 클러스터링 모델 등이 있습니다. 많은 사람들은 AI 개발자나 데이터 사이언티스트가 주로 이런 모델을 만드는 데 집중한다고 생각할지도 모릅니다. 물론 AI 모델을 구축하기 위해서는 복잡하고 정교한 모델 구조가 필요하지만, 그보다 더 필수적인 자원이 있습니다. 바로 빅데이터입니다.
[How Much Data Is Generated Every Day in 2024?]에 따르면, 매일 무려 3.5 퀸틸리언 바이트의 데이터가 생성됩니다. 예를 들어, X(구 트위터)에서는 매 분 456,000개의 트윗이 생성되고, 인스타그램에는 매일 500만 개의 게시물이 올라옵니다. 이렇게 방대한 양의 데이터는 AI 모델을 만드는 데 활용될 수 있습니다. 그러나 원시(raw) 데이터는 그대로 모델 학습에 사용할 수 없습니다. 그 안에는 잡음(noise)이 많기 때문에 전처리(preprocessing)가 반드시 필요합니다.
예를 들어, 과자 종류를 분류하는 분류 모델을 개발한다고 해봅시다. EfficientNet이라는 잘 알려진 분류 모델을 선택하고, 10,000장의 과자 이미지를 수집했다고 가정합니다. 이 데이터셋은 250종류의 과자를 포함하며, 각 종류당 40장의 이미지가 있습니다.
모델을 선택하고 데이터셋을 모았다고 해서 바로 학습할 수는 없습니다. 각 이미지에 대응되는 제품명을 라벨링해야 하는데, 이 작업은 보통 사람이 직접 수행합니다. 이때 데이터를 라벨링하는 사람을 “오라클(oracle)”이라고 부르기도 합니다.
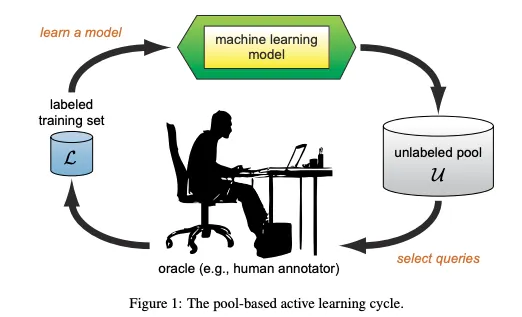
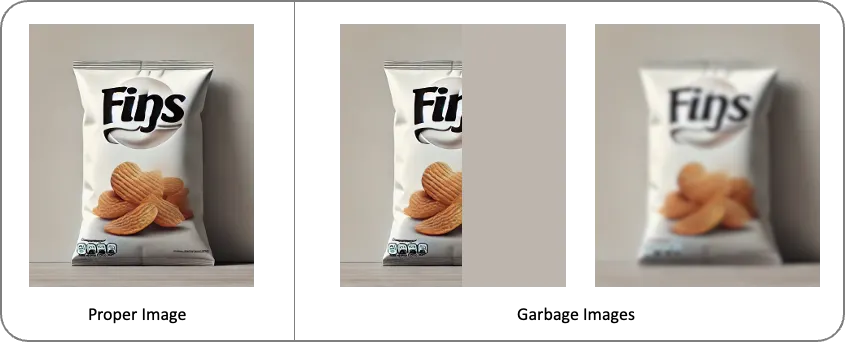
의자에 앉아 10,000장이 넘는 이미지를 하나하나 라벨링한다고 상상해보세요. 엄청난 시간과 에너지가 소모될 것입니다. 게다가 수집한 데이터 중에는 초점이 맞지 않은 사진이나, 제품이 잘려 있는 이미지 같은 쓰레기 데이터(garbage data)도 포함되어 있을 수 있습니다. 그렇다면 이런 의문이 생깁니다.
가장 중요한 이미지를 우선적으로 라벨링할 수는 없을까?
쓰레기 데이터를 걸러내고, 모델에 큰 영향을 주는 데이터만 선택할 수는 없을까?
만약 중요한 데이터부터 라벨링할 수 있다면, 훨씬 더 빠르게 프로토타입 모델을 만들 수 있을 것입니다.
이 문제를 해결할 수 있는 방법이 바로 Active Learning(능동 학습)입니다.
Active Learning은 데이터 라벨링에 필요한 시간을 효과적으로 줄여주는 기법으로, 모델 학습에 큰 영향을 미칠 가능성이 있는 데이터를 우선적으로 선택하여 라벨링하도록 합니다.
Active Learning은 데이터의 형태에 따라 Pool-based, Population-based, Stream-based 시나리오로 나눌 수 있습니다. 또한, 데이터를 선택하는 전략도 다양합니다.
Uncertainty Sampling (불확실성 샘플링): 모델이 가장 확신하지 못하는 데이터를 선택
Query-By-Committee (위원회 기반 질의): 여러 모델의 의견이 불일치하는 데이터를 선택
Expected Model Change (예상 모델 변화): 해당 데이터를 학습했을 때 모델이 크게 바뀔 데이터를 선택
오늘은 Active Learning 개념을 소개했습니다.
다음에서는 Active Learning의 구체적인 시나리오와 전략에 대해 더 깊이 다루겠습니다.
[References]
[1] Settles, Burr. “Active learning literature survey.” (2009).
[2] D. Wu, “Pool-Based Sequential Active Learning for Regression,” in IEEE Transactions on Neural Networks and Learning Systems, vol. 30, no. 5, pp. 1348–1359, May 2019, doi: 10.1109/TNNLS.2018.2868649.
 GitHub
 LinkedIn